Claude Fable 5.2 跑分和实测:比 Opus 5.5 强在哪,Pro 和 Max 能用多少额度
Anthropic 在 11 月 9 日发布了 Claude Fable 5.2。官方基准里,它在智能体编程、电脑操作和机器人仿真上大多排在第一,图表理解也是。Artificial Analysis 的综合智能指数(Intelligence Index)也把它排到 74 个模型里的第一名。代价同样明显。同一套评测里,它的单任务成本在所有模型里最高,网友实测普遍反映额度掉得很快。
想现在就试的话,Pro 用户在 11 月 16 日之前可以直接用套餐额度跑 Fable 5.2,最多占周额度的一半,发布前已经付费的账号还会多拿到一次免费的 Fable 额度重置。Max 用户一直可以用,同样最多占周额度的一半。
按问题阅读
跑分强在哪网友实测Pro 和 Max 额度什么任务值得切换在 EzSub 开通
Fable 5.2 的跑分强在哪
Fable 5.2 和 Mythos 5.2 是同一个底层模型。普通付费用户用的是 Fable 5.2,Mythos 5.2 只开放给通过 Anthropic 验证计划的机构。和 9 月的 Fable 5.1 相比,5.2 的输出速度最多快 30%,API 价格从每百万 token 输入 $10、输出 $50 降到 $8 和 $40,上下文 1M,单次最多输出 128K。
下面这张表取自 Anthropic 的 Fable 5.2 介绍页,分数是开着安全措施、各模型用最高 effort 跑出来的:
| 基准(考察方向) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0(智能体编程) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2(软件工程) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| Terminal-Bench-Science 0.1(终端科研任务) | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1(操作电脑) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim(机器人仿真) | 64.9% | 27.6% | 39.4% | 29.8% | — |
| Chartography(读图表) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
| AutomationBench(流程自动化) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
涨幅最大的一项是机器人仿真。有网友看完这张表专门指出,RoboDojo Sim 从 5.1 的 27.6% 涨到 64.9%,是原来的 2.4 倍。读图表的 Chartography 从 44.8% 到 73.4%,跟写前端关系很大,因为模型要靠截图检查页面有没有排版问题。编码两项各涨了十几分,FrontierCode 2.0 比 Opus 5.5 高 3.6 分。
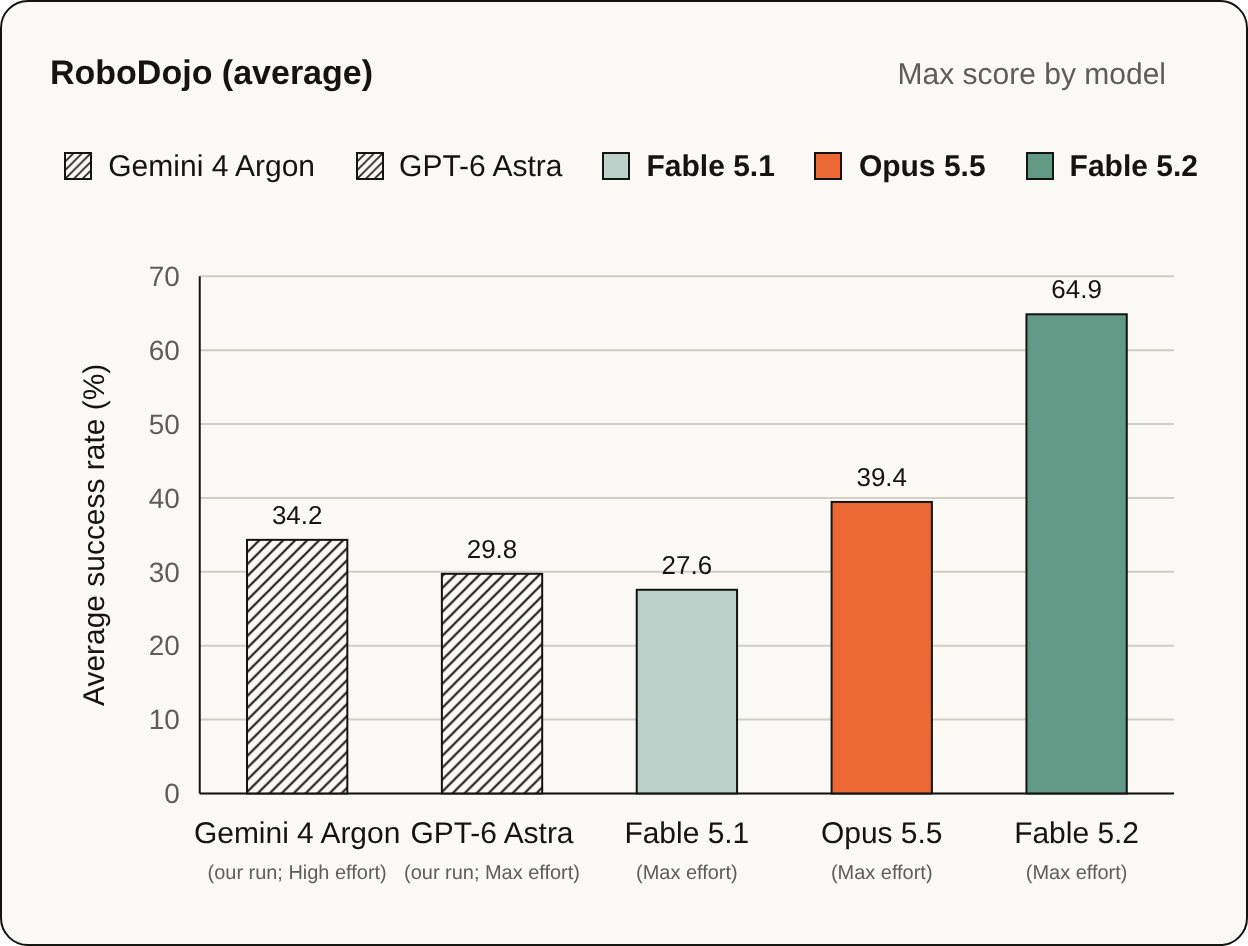
图:RoboDojo 机器人仿真平均成功率,各模型用最高 effort。图源:Anthropic
它也有输的项目。流程自动化的 AutomationBench 低于 Gemini 4 Carbon,AA-Briefcase 的 Elo 分是 1785,比 Opus 5.5 的 1800 略低。
第三方榜单的结论差不多。Artificial Analysis 的综合智能指数给了 Fable 5.2 65 分,排第一。有网友整理的数据是 Gemini 4 Carbon 60 分,Opus 5.5 59 分。同一个页面也列出了成本。最高档平均每题花 $26.54,在 73 个模型里最贵,评测期间输出了 2.75 亿 token,是中位数的 3.8 倍左右。这位网友还提到,high 档的分数是 62,每题约 $9、18 分钟,比最高档每题 44 分钟划算得多。
官方公告里的几个案例更能说明它擅长什么样的任务。1000 多个子智能体用了大约 8 天,做出一个能启动的原型操作系统。约 1000 个智能体用 30 小时完成了费马大定理的 Lean 形式化,同样配置下 Opus 5.5 跑了 18 小时,只完成 26%。Anthropic 还和 Diode 合作,用它设计了三款能实际工作的电子设备。这些都是大工程,要连续跑很久,还要拆给很多智能体协作,日常问答看不出这种差距。
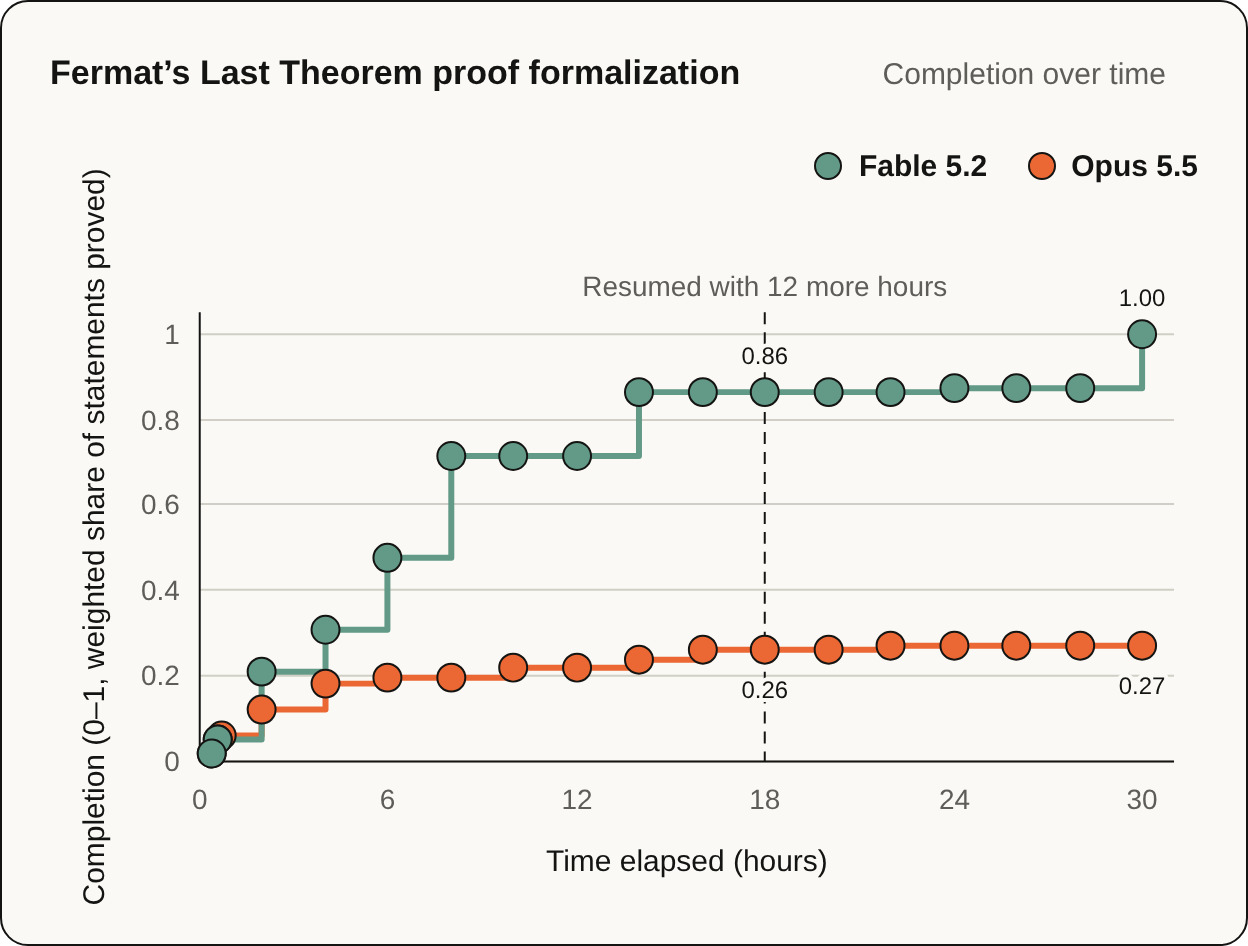
图:费马大定理 Lean 形式化的完成度,绿色为 Fable 5.2,橙色为 Opus 5.5。图源:Anthropic
网友实测:审美、速度和额度消耗
X 上的中文用户这两天发了不少实测,看法相当一致。做出来的东西细节好、审美高,花的钱和额度也多。
一位 AI 博主用的是额度较高的订阅,开 Xhigh 跑了大约 10 个任务、4 个小时,用掉约 24% 的周额度,Fable 能用的那部分几乎见底。他让 Fable 5.2 一次做完一条 ChatGPT 四周年回顾视频,用时约 1 小时,他没在里面找到事实错误。做苹果静安店的 3D 模型花了约 2.5 小时,过程中模型自己看了大约 100 张参考照片。他的结论是日常工作继续用 Opus 5.5,Fable 留给规划和“指挥官”一类的角色。他还提到,Fable 5.2 说话更直接,会反驳他原本的思路。
一位程序员博主在 Cursor 里开了 3 个子智能体,每个都用 Fable 5.2 独立做一个纯前端项目,中途不做人工干预。第一个项目把 AI 编程学习路线做成古风卷轴网页,另外两个是重庆城市生成器和桐庐瑶琳仙境溶洞探秘。三个项目各跑了 86、88、91 分钟左右。卷轴项目首版一次跑通,之后模型自己看截图修了 6 轮。纸纹、山水和印章全部用 SVG 代码画出来。溶洞项目一开始黑屏,控制台没有报错,模型逐个材质排查,才发现着色器算出了非法数值,前后修了 8 轮。三个项目加起来花了他 500 多元人民币。他的评价是前端审美依然顶级,但比 Opus 5.5 的提升不算明显,速度也没感觉更快。
还有一位 Pro 用户简单测了一次,用 Fable 5.2 做一个视频,消耗了 5 小时额度的 74% 和周额度的 13%。
额度为什么掉得这么快,有网友转述了一位开发者的估算。同样的订阅额度,全部换成 Fable 5.2,能换到的 API 等价用量大约只有 Opus 5.5 的五分之一。这位开发者也提到,Fable 有时一轮就能做完 Opus 要来回好几轮的任务,所以按完成的任务数算,差距会小一些。
Pro 和 Max 现在能用多少
| 套餐 | 能不能用 Fable 5.2 | 额度怎么算 | 免费重置 |
|---|---|---|---|
| Free | 不能 | — | — |
| Pro | 11 月 16 日前可以 | 算进套餐额度,最多占周额度的一半 | 1 次,16 日到期 |
| Max | 可以 | 算进套餐额度,最多占周额度的一半 | 按订阅时长 1–3 次,2027 年 3 月 8 日到期 |
“最多占周额度的一半”是从原有的周额度里划出一半给 Fable,没有额外加量。Fable 5.2 消耗额度的速度又比其他模型快,周额度会比平时掉得更快。Fable 那一半用完后,可以换回 Opus 5.5 等模型,继续用剩下的周额度。
Pro 用户的这次开放截止到美西时间 11 月 16 日 23:59,对应北京时间 17 日 15:59。之后 Pro 再用 Fable 5.2,要另外开通按 API 价格计费的 usage credits。
免费重置是这次最实用的一项。它会把这周已经用掉的 Fable 周额度退回来,如果账号有 5 小时额度限制,5 小时额度也会一起补满,相当于一张卡同时刷新 Fable 周额度和 5 小时额度。它不会提高上限,用过也撤不回,所以有网友建议先把 Fable 周额度用到快见底再点。入口在“设置 > 用量”里的“Reset for free”。重置只发给已经付费的账号,付费时间要早于 11 月 9 日美西时间上午 10 点,完整规则见官方帮助中心的 Claude Fable 5.2 launch offers。
按前面那位 Pro 用户的数据,做一个视频就要 74% 的 5 小时额度。Pro 用户这周比较顺的用法是先挑一个最想让 Fable 做的任务,5 小时额度快用完时点一次重置,接着把任务做完。
默认模型不会自动换成 Fable 5.2。网页、桌面端和手机 App 都要在模型选择器里手动选“Fable 5.2”,Claude Code 需要升级到 2.1.321 或更高版本。
什么任务值得切到 Fable 5.2
Anthropic 自己的建议是大多数编程和知识类任务先用 Opus 5.5,遇到最难、最开放的技术工作再换 Fable 5.2。把这条建议和上面的实测放在一起看,下面几类任务最值得交给它。
第一类是要跑很久的工程任务,比如多个子智能体协作的大项目、需要反复自查的长代码改造。Fable 5.2 有时一次就能把任务收尾,省下来的来回沟通能抵掉一部分单价。第二类是前端和视觉要求高的作品,网页、3D 场景,还有动画和视频,这是上面两位博主都给了高评价的方向。第三类是当“指挥官”,让 Fable 5.2 做规划、拆任务和审方案,具体的执行交给 Opus 5.5。官方也提到它可以当 Advisor 或 Orchestrator。Fable 只负责关键判断,大量执行用的 token 落在单价更低的 Opus 5.5 上。
日常问答、改一段文案或者写个小脚本,用 Opus 5.5 就够了。Fable 5.2 在这些任务上看不出明显差距,额度却掉得快得多。
effort 档位也影响成本。Claude 应用和 Claude Code 默认是 medium,官方说这一档在难任务上比 5.1 用的 token 更少。按 Artificial Analysis 的数据,high 档分数只比最高档低 3 分,每题的花费和耗时都不到最高档的一半。除非任务真的很难,一般用 high 就够了。
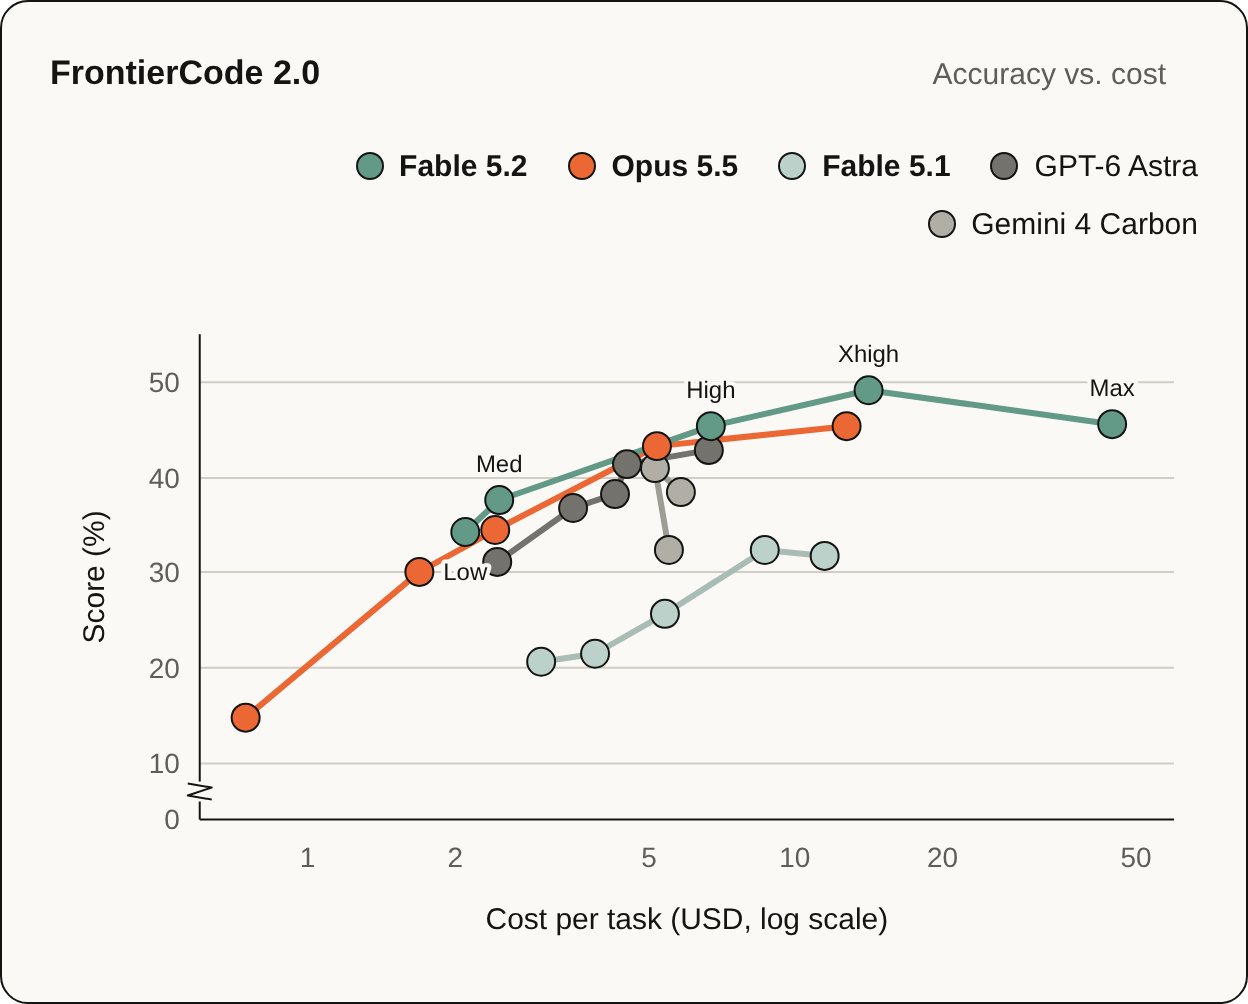
图:FrontierCode 2.0 的分数和单任务成本。High 档的 Fable 5.2 得分 45.3%,接近 Opus 5.5 最高的 45.5%,成本约为一半。图源:Anthropic
所有请求都会经过安全分类器。涉及进攻性网络安全、生物两用技术等方向的请求被拦下后,会自动交给 Opus 模型回答,界面会提示并标出实际回答的模型。和 5.1 相比,5.2 的拦截少了约 55%。不想自动换模型,可以在“设置 > Capabilities”里关掉“Switch models when a message is flagged”。
在 EzSub 开通 Claude Pro 或 Max
在 EzSub,你可以用人民币开通 Claude Pro 和 Max,商品都是 30 天规格。Pro 是 ¥188,Max 5x 是 ¥899,Max 20x 是 ¥1,880。下单时提供 Claude 账号的 Organization ID,我们人工充值,一般 5–60 分钟内到账。
只想这周试一下 Fable 5.2,Pro 就够用,16 日前可以直接用套餐额度跑。想在 16 日之后长期使用 Fable 5.2,又不想另外为 usage credits 付费,选 Max 更合适,Fable 一直包含在月费里。经常一跑就是几个小时的重度用户,可以直接看 Max 20x。
各规格的价格和下单入口见 Claude 充值。